遅いバッチは直す前に測る|ボトルネックを見つける5つの手順
朝8時、チャットに一言届きます。「今日の売上集計、まだ見られないんですけど」 確認すると、夜中の集計バッチがまだ動いている。数年前は2時に始まって3時前には終わっていたのに、最近は少しずつ遅くなって、とうとう始業に間に合わなくなった——。
「どこが遅いの?」と聞かれても、すぐには答えられない。とりあえずサーバーを増強するか、それとも怪しそうなSQLを直してみるか。気持ちは焦りますよね。
でも、ここでひと呼吸おいてください。答えに詰まるのは、あなたの力不足ではありません。まだ誰も測っていないから、わからないだけです。遅いバッチは、直す前に測る。それだけで、打つ手はぐっと絞れます。
この記事では、遅いバッチのボトルネックを見つけるための計測の順番を整理します。特別な監視ツールは使いません。Linux に標準で入っている(または入れやすい)コマンドと、ログへの一行の追記だけで進めます。
結論:遅いバッチは、①全体の時間と「いつから遅いか」を記録する → ②区間ごとに時刻を打って、どこが長いかを見る → ③その区間が「計算」で遅いのか「待ち」で遅いのかを見分ける → ④件数と時間の関係を見る → ⑤直す前の数字を「基準値」として残す の順で測ります。ボトルネックはたいてい1か所です。全体を速くしようとせず、いちばん長い区間を1つ見つけられれば十分です。
なお、以下のコマンドは一般的な Linux 環境を前提にしています。ディストリビューションやバージョンで、入っているコマンドや出力の形が変わります。本番で使う前に、お使いの環境のマニュアル(man コマンド)で確認してください。
何が起きているか:バッチは「ある日突然」ではなく「少しずつ」遅くなる
障害と違って、遅くなるバッチにはアラートが鳴りません。毎晩ちゃんと終わっているうちは、誰も時間を気にしないからです。
- データが少しずつ増えている:処理する件数が毎月増えれば、時間も毎月少しずつ伸びます。ある月に「始業に間に合わない」という線を越えて、初めて問題になります。
- 件数に比例しない遅さがある:ループの中で毎回テーブルを全件検索している、といった書き方だと、件数が2倍になると時間が4倍近くになることもあります。最初は気にならなかった遅さが、急に目立ち始めます。
- 同じ時間帯の処理と重なっている:バックアップ、別のバッチ、ログの圧縮。どれかの時刻が変わっただけで、ディスクやDBの取り合いが起きます。
- 勘で直すと外れやすい:「DBが遅いはず」とインデックスを足したのに、実は外部へのファイル転送で待っていた。直したのに速くならず、時間だけが過ぎる。これがいちばんつらいパターンです。
だから、直す前に測ります。ここは現場でも、つい飛ばしてしまいやすいところです。順番を決めておきましょう。
遅いバッチのボトルネックを見つける5つの手順
① 全体の時間と「いつから遅いか」を記録する
まずは、バッチ全体が何分かかっているかを、数字でつかみます。「最近遅い気がする」を「先月は45分、今月は2時間40分」に変えるだけで、相談も判断もしやすくなります。
- 過去のログを見る:バッチのログに開始・終了の時刻が出ていれば、それを日ごとに並べます。cron の実行記録(
/var/log/cron、/var/log/syslog、journalctlなど)や、出力ファイルの更新日時からも、終わった時刻のおおよそはわかります。 - これからの実行を測る:起動している行の先頭に
timeを付けるのが手軽です(例:time /opt/app/bin/monthly_sum.sh)。終わるとreal(実際にかかった時間)、user・sys(CPUを使った時間)が出ます。この3つは手順③でも使うので、メモしておきます。
ここで「いつから遅くなったか」も確かめておきます。ある日を境に急に遅くなったなら、その日の変更(リリース、設定変更、データ移行、他のバッチの時刻変更)がまず疑わしい候補です。少しずつ遅くなっているなら、データ量の増加を疑います。
② 区間ごとに時刻を打って、どこが長いかを見る
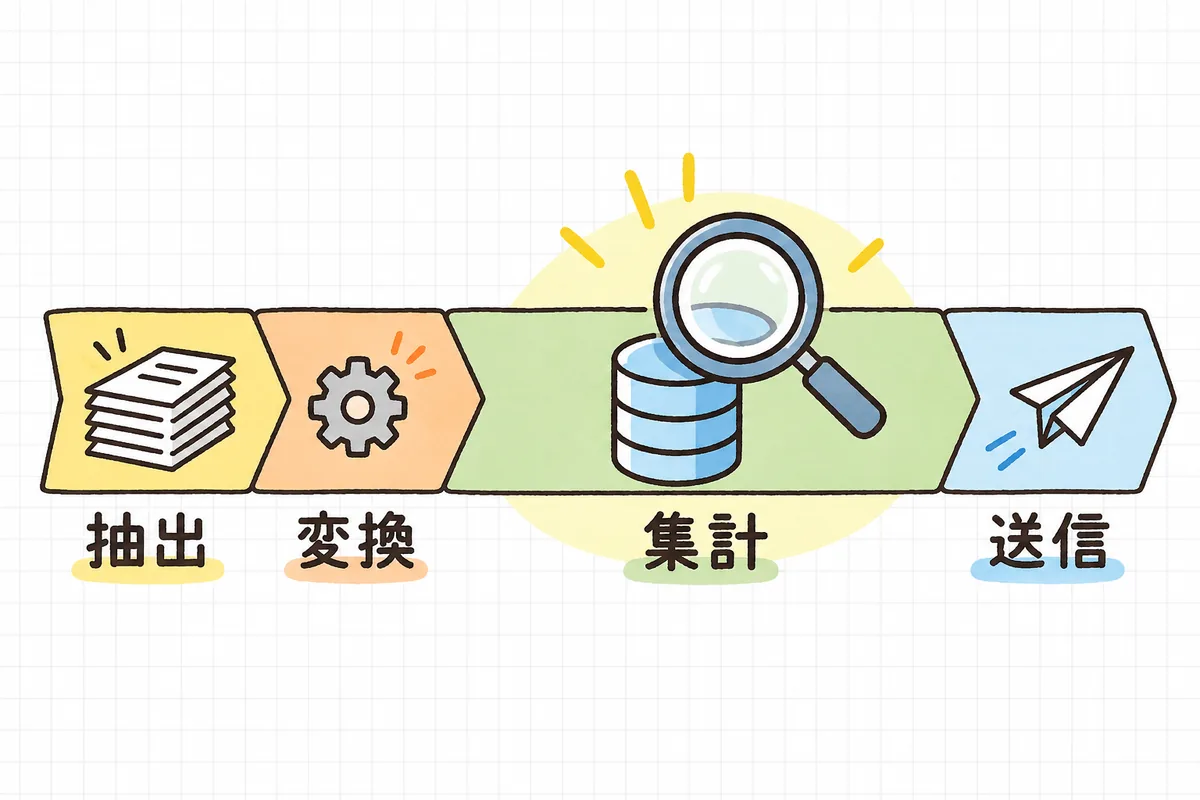
いちばん効くのがこの手順です。バッチを「抽出 → 変換 → 集計 → 送信」のような区間に分けて、それぞれの開始と終了の時刻をログに出します。
シェルスクリプトなら、区間の境目に1行ずつ足すだけです。
echo "$(date '+%F %T') 集計 開始"
# ……集計の処理……
echo "$(date '+%F %T') 集計 終了"
PHP や Python のバッチでも、区間の前後で時刻と処理件数をログに出すだけで十分です。並べてみると、たいていこうなります。
| 区間 | 所要時間 | 全体に占める割合 |
|---|---|---|
| 抽出 | 2分 | 約1% |
| 変換 | 5分 | 約3% |
| 集計 | 150分 | 約94% |
| 送信 | 3分 | 約2% |
| 合計 | 160分 | 100% |
この場合、抽出や送信をどれだけ速くしても、全体はほとんど縮みません。直すべきは「集計」の区間だけだとわかります。
ログの追記も、小さいとはいえ改修です。いきなり本番のファイルを書き換えず、検証環境で動きを確かめてから、いつもの手順で反映します。ログの入れ方のコツは改修時にログを仕込む|あとから原因を追えるログの残し方で整理しています。
③ その区間が「計算」で遅いのか「待ち」で遅いのかを見分ける
長い区間が見つかったら、次はなぜ長いのかを見分けます。ざっくり分けると、遅さには2種類あります。
- 計算で遅い:CPUを使い続けている(大量のデータを並べ替えている、無駄なループが回っている など)。
- 待ちで遅い:CPUはほとんど使わず、何かを待っている(ディスクの読み書き、DBの応答、外部APIやファイル転送 など)。
見分けるいちばん簡単な手がかりは、手順①でメモした time の数字です。
user+sysがrealに近い → 計算で遅い可能性が高い。user+sysがrealよりずっと小さい → ほとんどの時間を待っている。
たとえば real 160分 に対して user 6分・sys 1分 なら、CPUを使っていたのは全体の5%足らず(7 ÷ 160 ≒ 4.4%)。残りは何かを待っていた計算です。
待ちの相手を絞るには、バッチが動いている時間帯に、次のコマンドで様子を見ます。
top:そのバッチのプロセスの CPU 使用率。上部のwa(I/O待ち)の値も見ます。vmstat 5:5秒ごとの推移。waの列が高ければ、ディスクの読み書きを待っています。iostat -x 5:ディスクごとの使用状況(sysstatパッケージに含まれます)。%utilが張り付いているディスクがないかを見ます。- DB側:バッチの時間帯のスロークエリログや、実行中のクエリ一覧。DBの見方は急に重くなったDB|スロークエリの特定と一次対処の順番にまとめています。
CPUもディスクも落ち着いているのに時間がかかっているなら、外部API・ファイル転送・ロック待ちのように、サーバーの外や別の処理を待っている可能性が高まります。CPUの見方はCPU使用率が高いときの原因プロセス特定手順、数字の読み方はロードアベレージの正しい読み方も参考になります。
④ 件数と時間の関係を見る
区間のログに処理件数も出しておくと、もう一歩踏み込めます。過去の数か月分を、件数と所要時間で並べてみてください。
- 件数が2倍で、時間もおよそ2倍 → 件数に比例して素直に遅くなっています。1件あたりの処理を軽くするか、まとめて処理する方向で考えます。
- 件数が2倍で、時間が4倍近く → 件数の2乗に近い増え方です。ループの中で毎回大きなテーブルを全件検索している、1件ずつ一覧から探している、といった書き方を疑います。
- 件数はほぼ同じなのに、時間だけ伸びている → データ量以外の原因です。同じ時間帯の別の処理、DBの実行計画の変化、外部の応答の遅れなどを疑います。
この見分けがつくと、「サーバーを増強すれば済むのか、書き方を直すべきなのか」を落ち着いて説明できるようになります。
⑤ 直す前の数字を「基準値」として残す
最後に、いま測った数字をそのまま残しておきます。完璧な資料でなくてかまいません。
| 項目 | 書く内容 |
|---|---|
| 全体の時間 | 例:160分(real)、user 6分・sys 1分 |
| 区間ごとの時間 | 例:抽出2分/変換5分/集計150分/送信3分 |
| 処理件数 | 例:20万件(前年同月は10万件) |
| 測った日・条件 | 日付、同じ時間帯に動いていた処理 |
| いちばん長い区間 | 例:集計(ほぼ待ち。DBの応答待ち) |
| 次に試すこと | 例:集計のSQLを EXPLAIN で確認 |
この基準値があると、直したあとに同じ条件で測り直して比べることができます。「たぶん速くなった」ではなく「160分が18分になった」と言えるのは、直す前の数字があるからです。効果の確かめ方は直したつもりが直っていない|改修の効果を確かめる4つの手順で整理しています。
具体例:月次の売上集計バッチが始業に間に合わない
冒頭のバッチを、この順番で測ってみます。
- 全体の時間:ログを並べると、1年前は45分前後。それが毎月少しずつ伸びて、今月は160分。ある日を境に急に、ではなく、少しずつ遅くなっていた。
- 区間ごとの時刻:検証環境で動作を確かめてから、区間の境目に時刻を出す行を追加。翌月の実行で、集計の区間だけで150分(全体の約94%)かかっているとわかった。
- 計算か待ちか:
timeの結果はreal 160分に対してuser+sysが7分ほど。ほとんど待っている。実行中のtopでもCPUは低く、DBのスロークエリログに、同じ形のSELECTが大量に記録されていた。 - 件数と時間:処理件数は1年前の10万件から20万件へ約2倍。一方、集計の時間は約4倍。ループの中で1件ごとに、インデックスの効いていない条件でテーブルを検索している書き方が見つかった。
- 基準値:ここまでの数字を1枚にまとめ、「集計区間のループ内検索が原因。サーバー増強ではなく、検索条件へのインデックス追加を検証する」と記録した。
検証環境でインデックスを追加して同じ件数で測ると、全体は160分から18分に。本番への反映は、いつもの変更手順に沿って別の日に行いました。サーバーを増強していたら、費用をかけたうえで、ほとんど速くならなかったかもしれません。
影響:測っておくと、何が変わるか
- 打ち手を外さない:遅い区間とその理由がわかっていれば、的外れな改修やサーバー増強に時間とお金を使わずに済みます。
- 説明ができる:「集計のこの部分が全体の9割以上を使っていて、原因はこれです」と言えれば、上司や依頼元との相談がずっと進めやすくなります。
- 効果を示せる:基準値があるので、直したあとに「どれだけ良くなったか」を数字で伝えられます。
- 次の遅れに早く気づける:区間ごとの時刻がログに残り続けるので、また伸び始めたときにすぐ気づけます。バッチの失敗に気づく仕組みはcronバッチの失敗に気づく仕組みも参考になります。
明日やること:いちばん気になるバッチの「全体の時間」を並べる
一度に全部やらなくて大丈夫です。今日はここだけ確認できれば十分です。
- 遅くなって困っているバッチを1本だけ選ぶ。
- 過去のログや出力ファイルの更新日時から、ここ数か月の所要時間を並べる。
- 「ある日を境に急に遅くなった」のか「少しずつ遅くなった」のかを見る。
- 次の実行で
timeを付けて、real・user・sysをメモする段取りをする。
ここまでで30分ほど。区間ごとのログ追加は、検証環境で確かめてから、別の日に進めればかまいません。
遅いバッチ 計測チェックリスト
全部に○が付かなくても大丈夫です。わかったところから埋めていきましょう。
全体をつかむ
- バッチ全体の所要時間を、数字で把握したか
- ここ数か月の推移を並べ、「急に」か「少しずつ」かを見たか
- 遅くなり始めた時期の変更(リリース・設定・時刻変更)を確かめたか
区間を見る
- 処理を区間に分けて、それぞれの時刻をログに出したか(検証環境で確かめてから)
- いちばん長い区間と、全体に占める割合がわかったか
- 区間ごとの処理件数もログに出したか
理由を見分ける
-
timeのrealとuser+sysを比べ、計算か待ちかを見分けたか - 待ちなら、ディスク・DB・外部のどれを待っているか当たりを付けたか
- 同じ時間帯に動いている別の処理がないか確かめたか
- 件数と時間の増え方(比例か、それ以上か)を見たか
記録する
- 直す前の数字を基準値として残したか
- 直したあと、同じ条件で測り直す予定を立てたか
よければ、こちらも
遅いバッチの計測は、バッチの正体の解読や、改修の効果確認とひと続きの作業です。あわせて読むと、測った数字が次の判断に生きてきます。
- 誰も中身を知らないバッチを解読する|止める前に確かめる5つの手順:測る前に、そもそも何をしているバッチかをつかむ方法です。
- 急に重くなったDB|スロークエリの特定と一次対処の順番:待ちの相手がDBだったときに、遅いクエリを特定する手順です。
- 直したつもりが直っていない|改修の効果を確かめる4つの手順:基準値と比べて、直した効果を確かめるときに。
- 監視の平常値(ベースライン)を把握する|「いつもと違う」に早く気づく方法:バッチの時間も「いつもの値」を持っておくと、伸び始めに気づけます。
- 調査を長引かせない|タイムボックスと打ち切り・相談の判断:計測が長引きそうなとき、どこで区切って相談するかの考え方です。
毎晩のバッチが少しずつ遅くなっていくのに気づいて、なんとか朝に間に合わせようとしてきたこと自体が、もう立派な保守の仕事です。 まずは1本だけ、ここ数か月の所要時間を並べてみてください。数字がひとつ見えるたびに、「なんとなく遅い」は「ここを直せばいい」に変わっていきます。
ほかの実務ヒントは記事一覧からどうぞ。保守運用の小さな備えを、メールでも少しずつお届けしています。