同時実行で壊れるバグの見つけ方|排他制御の漏れを探す4つの手順
「在庫、マイナス1になってるんですけど……」
ある朝、そんな連絡が届く。在庫が足りなければ注文できないはずの画面です。自分で同じ商品を何度注文してみても、ちゃんと「在庫切れ」と表示される。ログにもエラーは出ていない。「どこも壊れていないのに、なぜ?」——画面の前で手が止まる、あの感じ。保守をしていると、一度は出会う不思議です。
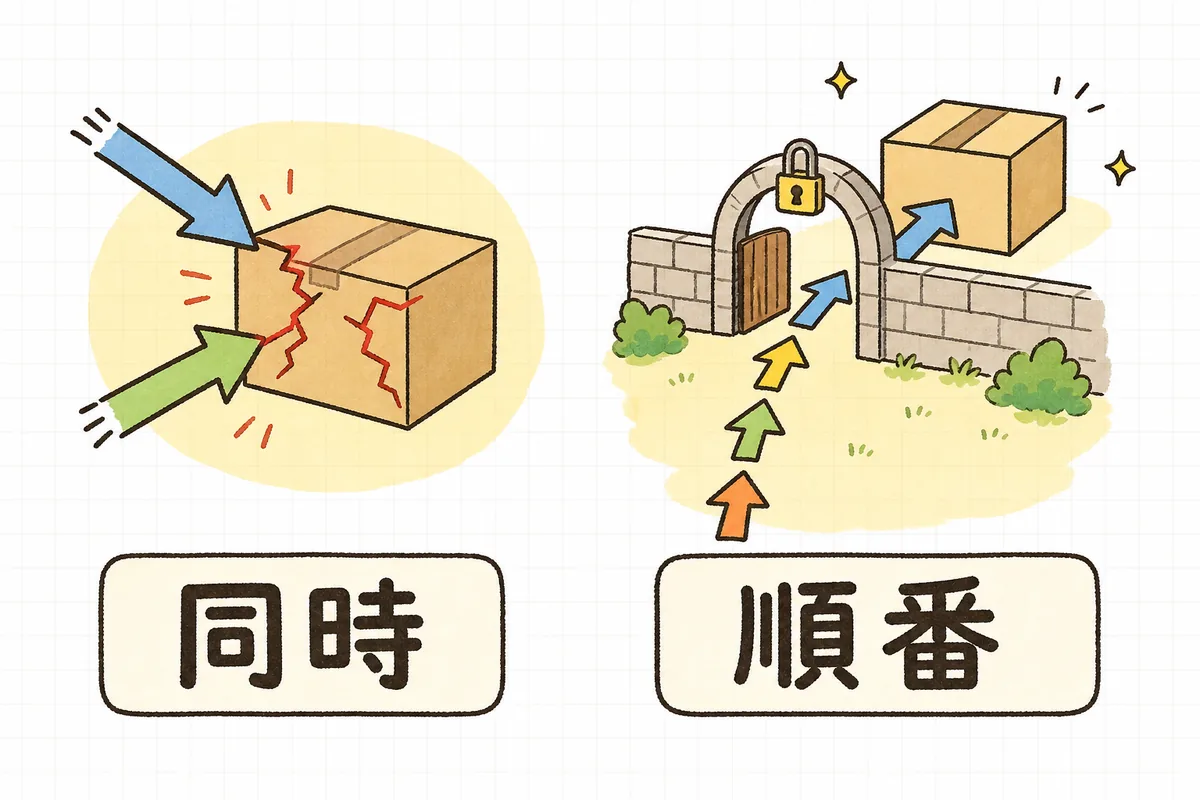
これは、あなたの調べ方が悪いわけではありません。一人で静かに試しているあいだは、絶対に起きない種類のバグがあるのです。2つの処理が「ほぼ同時」に同じデータを触ったときだけ壊れる——いわゆる同時実行(競合状態)のバグです。
この記事では、そんなバグを見つけるための順番を、小さく分けて一緒に整理していきます。
結論:同時実行のバグは、次の4つの順で追います。①症状が「同時実行の型」に当てはまるかを見る(たまに・混む時間・数がずれる)、②ログで「同じデータへの、ほぼ同時のリクエスト」を探す、③コードで「読んでから書く」箇所を探す、④検証環境で、わざと同時に叩いて再現する。直し方は、DBの一意制約・条件付きの更新・行ロックなど、「同時に来ても1つずつ処理される仕組み」をどこか1か所に置くのが基本です。
なお、SQLやコマンドはDBの種類・バージョン・フレームワークで挙動が変わります。ここで持ち帰ってほしいのは順番と観点です。手元の環境に置き換え、必ず検証環境で試してから使ってください。
何が起きているか:「読んでから書く」のあいだに、別の処理が割り込む
同時実行のバグの多くは、こんな流れで起きます。在庫が1個の商品に、2人のお客さんがほぼ同時に注文した場面です。
- 注文Aの処理が在庫を読む → 「1個ある」
- 注文Bの処理が在庫を読む → 「1個ある」(Aはまだ書き換えていない)
- 注文Aが「在庫あり」と判断して、在庫を 1 − 1 = 0 に書き換える
- 注文Bも「在庫あり」と判断して、在庫を減らす → 0 − 1 = −1
一つひとつの処理は、正しく書かれています。ただ、「読む」と「書く」のあいだに、別の処理が割り込める隙間があった。それだけです。
この隙間は、一人で試すときはまず開きません。処理は一瞬で終わるので、次の操作をするころには前の処理が終わっているからです。だから手元では再現しないし、混む時間帯にだけ、たまに起きる。それが、このバグが見つけにくい理由です。
よくある症状は、次のような形で現れます。
- 数がずれる:在庫・残高・ポイント・座席数がマイナスになる、合計が合わない。
- 同じものが2つできる:同じ注文・同じ会員登録・同じ予約が2件入る。連番(伝票番号など)が重複する。
- 更新が消える:2人が同じ画面で編集し、あとから保存した人の内容で、先の人の変更が上書きされる。
- バッチが重なる:前回のcronが終わる前に次が起動して、同じ処理を二重に流す。
同時実行のバグを見つける4つの手順
① 症状が「同時実行の型」に当てはまるかを見る
最初に、いま追っているバグが同時実行のものかどうかを、症状から見当をつけます。次のうち2つ以上当てはまれば、疑ってみる価値があります。
- 手元では何度やっても再現しない(「再現しない」バグの調べ方を一通り試しても出ない)
- 混む時間帯・セール・締め日・月初にだけ起きる
- エラーは出ていないのに、結果の数や件数がおかしい
- 「ボタンを二度押しした」「タブを2つ開いていた」と依頼者が言っている
- 複数のサーバー・複数のワーカー・複数のcronが同じデータを触る構成になっている
最後の項目は意外と大事です。サーバーが1台・プロセスが1つのころは問題なかったのに、台数やワーカー数を増やしたあとから起き始めた——というのは、よくある流れです。
② ログで「同じデータへの、ほぼ同時のリクエスト」を探す
見当がついたら、壊れたデータ(例:在庫がマイナスになった商品)にほぼ同時に届いたリクエストがないかをログで探します。
# アクセスログから、問題の商品への注文リクエストを時刻つきで抜き出す(パス・形式は環境に合わせて)
grep "POST /order" /var/log/nginx/access.log | grep "item_id=1234" | awk '{print $4, $1, $7}'

# 同じ秒に2件以上来ていないかを数える([06/Oct/2026:10:15:03 のような時刻部分で集計)
grep "POST /order" /var/log/nginx/access.log | grep "item_id=1234" | awk '{print $4}' | sort | uniq -c | sort -rn | head
同じ秒(あるいは1秒以内)に、同じ商品への注文が2件並んでいたら、かなり有力な手がかりです。POSTの中身がアクセスログに出ない構成なら、アプリのログや注文テーブルの作成日時で代わりに並べます。
DB側からも、壊れ方を数字で確かめておきます。 重複ができている型なら、次のような集計で「本来1件のはずのものが2件ある」ことが分かります。
-- 同じ注文番号が2件以上ないかを確かめる(閲覧だけ。テーブル名・列名は環境に合わせて)
SELECT order_no, COUNT(*) AS cnt, MIN(created_at), MAX(created_at)
FROM orders
GROUP BY order_no
HAVING COUNT(*) > 1;
MIN(created_at) と MAX(created_at) の差がごくわずか(同じ秒や数百ミリ秒)なら、同時実行の線がさらに濃くなります。ログの絞り込み方はエラーログの見方|grep・tailで絞り込む手順も参考にしてください。
③ コードで「読んでから書く」箇所を探す
次に、そのデータを書き換えているコードを探し、「読む → 判断する → 書く」が別々の処理になっている箇所を見つけます。たとえば、こんな形です。
// 読んで、判断して、書く——このあいだに別の注文が割り込める
$stock = $db->query("SELECT stock FROM items WHERE id = 1234")->fetchColumn();
if ($stock >= 1) {
    $db->exec("UPDATE items SET stock = " . ($stock - 1) . " WHERE id = 1234");
    // 注文を登録する
}
探すときの目印は、次のようなものです。
- SELECTで値を取ってから、その値をもとにUPDATE / INSERTしている(残数チェック・重複チェック・連番の採番)
- 「すでに登録済みか」をSELECTで確かめてからINSERTしている(二重登録の温床)
- 編集画面で読み込んだ内容を、まるごと上書き保存している(更新が消える型)
- ファイルを読んで、書き換えて、書き戻している(カウンタファイル・設定ファイルなど)
- cronのバッチに、二重起動を防ぐ仕組みがない
grep -rn "SELECT.*stock" src/ のように、壊れたデータの列名でコードを検索すると、たどり着くのが早くなります。長いコードを追うときは長い関数・巨大ファイルの読み方も役に立ちます。
④ 検証環境で、わざと同時に叩いて再現する
怪しい箇所が見つかったら、検証環境で同時にリクエストを送って、本当に壊れるかを確かめます。本番では絶対に試さないでください。
# 検証環境で、同じ商品への注文を5件ほぼ同時に送る(URL・パラメータ・認証は環境に合わせて)
for i in 1 2 3 4 5; do
  curl -s -o /dev/null -w "%{http_code}\n" -X POST \
    -b "session=検証用のセッション" \
    -d "item_id=1234&qty=1" https://staging.example.jp/order &
done
wait
在庫を1にしてから流し、終わったあとに在庫と注文件数を見ます。在庫が0・注文が1件なら正しい動き、在庫がマイナスだったり注文が2件以上入っていたりしたら、再現できたということです。
一度で出ないこともあります。それは「起きない」ではなく「隙間が狭い」だけのことが多いので、件数を増やしたり、何度か繰り返したりしてみてください。どうしても出にくいときは、検証環境のコードの「読む」と「書く」のあいだに一時的に sleep(1) を入れると、隙間が広がって再現しやすくなります(確かめ終わったら必ず外します)。
再現できたら、もう半分は解けています。 直したあとに同じ手順を流して壊れなくなれば、それがそのまま「直った」の確認になります(修正の効果を確かめる手順)。
直し方の基本:「1つずつ順番に通す」仕組みを1か所に置く
原因が分かったら、同時に来ても1つずつ処理される仕組みをどこかに置きます。代表的なのは次の5つです。現場のコードとDBに合うものを1つ選べば十分です。
- DBの一意制約(UNIQUE):注文番号・メールアドレスなど「1件しかあってはいけない」列に一意制約を付ける。2件目はDBが弾いてくれるので、二重登録の型にいちばん確実に効きます。既存データに重複があると付けられないので、先に②の集計で重複を片づけます(本番データをSQLで安全に直す手順)。
- 条件付きの更新:読んでから計算するのをやめ、DBに「減らせるときだけ減らして」と1文で頼む。
  -- 在庫が1以上あるときだけ1減らす。更新件数が0なら「在庫切れ」として扱う
UPDATE items SET stock = stock - 1 WHERE id = 1234 AND stock >= 1;- 行ロック(SELECT ... FOR UPDATE):トランザクションの中で読むときに行をロックし、ほかの処理を待たせる。MySQL(InnoDB)でもPostgreSQLでも使えます。ロックを持つ時間が長いと、今度は待ちが詰まる原因になるので、トランザクションは短く保ちます(DB接続の枯渇・デッドロックの初動)。
- 楽観ロック(バージョン列):テーブルに
version列を持たせ、UPDATE ... SET ..., version = version + 1 WHERE id = ? AND version = 読んだときの値で更新する。更新件数が0なら「ほかの人が先に更新した」と分かるので、画面に「最新の内容を読み込み直してください」と出せます。編集画面で更新が消える型に向いています。 - cronの二重起動防止(flock):バッチを
flock -n /var/lock/daily-batch.lock php batch.phpのように起動すると、前回がまだ動いているあいだは次が起動しません(cron・バッチの失敗に気づく仕組み)。
画面のボタンを押したら無効にする「二度押し防止」も、あると親切です。ただ、それだけではブラウザの外から来るリクエストや、別の人の同時操作は防げません。最後の砦はDB側に置く、と覚えておくと迷いません。
具体例:「在庫がマイナスになる」を4つの手順で追う
小さな通販サイトを一人で保守している担当者の、よくある流れです。
- 以前:在庫マイナスの連絡が来るたびに、管理画面で在庫を手で0に戻して「データを修正しました」と返していた。月に1〜2回、セールの日にだけ起きる。手元では再現しないので、原因は分からないままだった。
- 4つの手順で追ったあと:①「セールの日だけ・エラーなし・数がずれる」で同時実行を疑った。②アクセスログで、マイナスになった商品に同じ秒の注文が2件並んでいるのを見つけた。③注文処理のコードに「在庫をSELECTしてから、計算した値でUPDATE」している箇所を見つけた。④検証環境で在庫1の商品に5件同時に注文を送ると、在庫が−1になって再現。UPDATEを
stock = stock - 1 WHERE ... AND stock >= 1の条件付き更新に直し、更新件数が0なら「在庫切れ」と表示するようにした。同じ5件同時の注文を流すと、注文1件・在庫0で止まるようになった。
変わったのは、腕の良し悪しではありません。「一人で試しても出ないバグがある」と知って、同時に叩いて確かめたことです。月に1〜2回の手直しも、それきりなくなりました。
影響:同時実行を疑えるようになると、何が変わるか
- 「原因不明」で終わる件が減る:再現しないバグに、もう一つ調べる道ができます。
- データを手で直し続けなくて済む:根本の隙間を埋めれば、同じ手直しを繰り返す時間が消えます。
- 構成を変えるときに先回りできる:サーバーやワーカーを増やす前に「同時に動いたら壊れる箇所はないか」と考えられるようになります(改修の影響範囲の調べ方)。
- 依頼者に説明しやすくなる:「同じ商品に同じ秒に2件の注文が来たときだけ起きていました」と、具体的に伝えられます。
明日やること
- 「たまに数がずれる」「たまに2件入る」系の未解決の問い合わせを1つ思い出す。同時実行の型に当てはまるか、①のリストで見てみます。
- 重複チェックのSQLを1本流してみる。注文番号・会員のメールアドレスなど、「1件しかないはず」の列で
GROUP BY ... HAVING COUNT(*) > 1を(閲覧だけで)実行します。 - cronのバッチに二重起動防止があるかを確かめる。crontabを開いて、長く動くバッチに
flockなどが付いているかを見るだけで大丈夫です。 - 大事なテーブルに一意制約が付いているかを確かめる。付いていなければ、メモに残して次の改修の候補にします。
今日やるのは、2の「重複チェックのSQLを1本流す」だけでも十分です。0件なら一安心、見つかったら原因へ近づく手がかりになります。
同時実行のバグを探すチェックリスト
- 手元で再現しない・混む時間だけ起きる・数がずれる、などの「同時実行の型」に当てはまるか見たか
- 壊れたデータに、ほぼ同時(同じ秒)のリクエストが来ていないかログで確かめたか
- 重複や数のずれを、SQLの集計で数字として確かめたか
- 「SELECTしてからUPDATE/INSERT」している箇所をコードで探したか
- 「登録済みか確かめてからINSERT」している箇所がないか見たか
- 編集画面が、読み込んだ内容をまるごと上書き保存していないか見たか
- cronのバッチに二重起動防止(flockなど)があるか確かめたか
- 本番ではなく検証環境で、同時リクエストを送って再現を試したか
- 直し方を、一意制約・条件付き更新・行ロック・楽観ロックのどれか1つに決めたか
- 直したあと、同じ同時リクエストを流して壊れないことを確かめたか
全部を一度にそろえなくても大丈夫です。まずは「同時実行を疑ってみる」と「重複チェックのSQLを1本流す」の2つだけで、見えなかった原因にぐっと近づけます。
よければ、こちらも
- 「再現しない」バグの調べ方:同時実行以外の「再現しない」理由も含めて、順番に絞り込むために。
- DB接続の枯渇・デッドロックの初動:ロックを入れたあと、待ちが詰まったときの見方を。
- cron・バッチの失敗に気づく仕組み:バッチの二重起動や失敗を、早めに知るために。
- 本番データをSQLで安全に直す手順:重複やマイナスになったデータを、安全に戻すときに。
- 改修時にログを仕込んで原因を追う:同時に動いた順番を、ログで見えるようにしたいときに。
「手元では再現しないのに」と首をかしげた時間は、無駄ではありません。それは、一人で静かに試すだけでは見えない場所に、ちゃんと目を向け始めたしるしです。あとは「同時に動いたら?」と一度だけ疑ってみる。それだけで、原因不明だったバグに、たどり着く道ができます。
まずは明日、「1件しかないはず」のテーブルに、重複チェックのSQLを1本だけ流してみてください。
ほかの実務ヒントは記事一覧からどうぞ。保守運用の小さな備えを、メールでも少しずつお届けしています。