使われていないテーブル・カラムの見極め方|消す前に確かめる順番
「user_tmp と user_old と user_bk2019、どれが何のためのテーブルなんだろう」 「このカラム、ほとんど NULL だけど、どこかで読んでいたらどうしよう」 「バックアップのダンプが年々重くなっているのに、消していいものが分からない」
——データベースを預かっていると、こういう正体の分からないテーブルやカラムに必ず出会いますよね。画面の機能と違って、DBの中身は外から見えません。誰がいつ作ったのかも、どこから読まれているのかも、見ただけでは分からない。だから消せないまま、少しずつ増えていきます。
消せないのは、あなたが臆病だからではありません。DBは消したら戻すのがいちばん大変な場所だと、ちゃんと分かっているからです。その慎重さは、そのまま持っていて大丈夫です。
この記事では、勘ではなく数字とコードと人の3つで使用実態を確かめて、段階を踏んで片付けるやり方を一緒に整理します。確認SQLは MySQL と PostgreSQL の例を載せますが、バージョンや構成で結果の出方は変わるので、手元の環境で読み替えてください。
結論:使われていないテーブル・カラムは、「消す」の前に「確かめる・名前を変えて待つ・退避する」を挟むと安全に減らせます。手順は、①候補を一覧にする → ②DBの統計で読み書きの回数を見る(数字)→ ③コード・ビュー・トリガー・外部の読み手を探す(コード)→ ④作った人・使う部署に聞く(人)→ ⑤名前を変えてしばらく待つ → ⑥退避を取ってから消す。とくに大事なのは、統計がいつから数えた数字なのかを確かめることと、消す前に必ず戻せる形を残すことの2つです。
調べた結果「やっぱり残す」と決めるのも、立派な結論です。正体が分かった時点で、そのテーブルはもう怖いものではなくなります。
何が起きているか:DBには「使われなくなった痕跡」が残りにくい
使われていないテーブルやカラムが溜まっていくのには、DBならではの事情があります。
- 作るのは簡単、消すのは怖い:一時的な集計や移行作業のために
CREATE TABLEするのは一瞬です。でも、消すときには「本当に誰も使っていないか」の証明が必要になります。 - アクセスログのような記録が標準では残らない:Webの画面ならアクセスログにURLが残りますが、DBは「どのテーブルが最後にいつ読まれたか」を、そのままの形では教えてくれません。
- 読み手がアプリの外にもいる:帳票ツール、BIツール、CSVの定期出力、別システムとの連携。アプリのコードを探しただけでは見つからない読み手がいます。
- **
SELECT *が「使っているように見せる」**:アプリがSELECT *で全カラムを取っていると、中身を誰も見ていないカラムでも、毎回読み出されていることになります。 - 年に1回だけ動く処理がある:決算や年度切替のときだけ参照されるテーブルは、ふだんの数か月を見ても「未使用」に見えます。
つまり、判断材料が足りないのはDBの性質によるもので、担当者の怠慢ではありません。材料を自分で集める順番さえ持っておけば、判断はずっと軽くなります。
見極めの順番:数字・コード・人の3つで確かめる
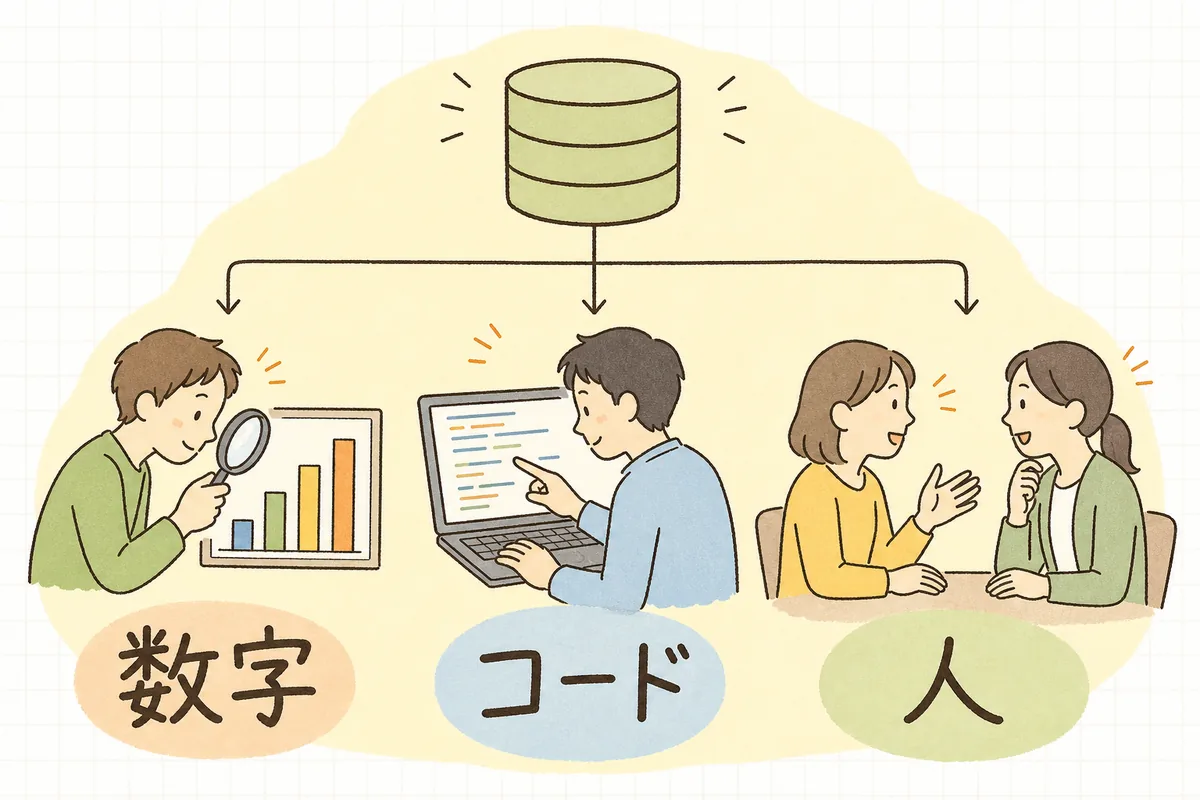
急がなくて大丈夫です。1つのテーブルについて、次の順番で進めます。
① 候補を一覧にする
まず、疑わしいものを書き出します。一度に全部片付けようとせず、1テーブルずつで構いません。候補になりやすいのはこのあたりです。
tmp_temp_work_old_bk_bak_copy_testのような名前が付いたテーブル- 日付が入った名前のテーブル(
orders_20210401など、移行や退避のときに作られたもの) - 行数がゼロ、または長いあいだ行数が増えていないテーブル
- ほぼすべての行が
NULLか同じ値になっているカラム - 「旧」「予備」「未使用」とコメントが付いているカラム
名前の一覧と行数は、まず次のようなSQLでざっと眺められます。
-- MySQL:スキーマ内のテーブルと、おおよその行数・サイズ
-- (InnoDB の TABLE_ROWS は概算値です。正確な件数は COUNT(*) で確かめます)
SELECT TABLE_NAME, TABLE_ROWS,
       ROUND((DATA_LENGTH + INDEX_LENGTH) / 1024 / 1024, 1) AS size_mb
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'your_db'
ORDER BY TABLE_NAME;
-- PostgreSQL:ユーザーテーブルと、おおよその行数
SELECT relname, n_live_tup
FROM pg_stat_user_tables
ORDER BY relname;一覧には「テーブル名/行数/疑う理由/作られた時期(分かれば)」の4列だけ書いておけば十分です。
② 数字で見る:DBの統計で読み書きの回数を確かめる
次に、そのテーブルが実際に読まれたり書かれたりしているかを、DBが持っている統計で確かめます。
MySQL では、Performance Schema が有効なら、テーブルごとの読み書きの回数を見られます(8.0 以降は既定で有効なことが多いですが、環境によっては無効にされています)。
-- MySQL:テーブルごとの読み取り・書き込み回数(サーバー起動時からの累計)
SELECT OBJECT_NAME, COUNT_READ, COUNT_WRITE
FROM performance_schema.table_io_waits_summary_by_table
WHERE OBJECT_SCHEMA = 'your_db'
ORDER BY COUNT_READ + COUNT_WRITE;

-- この数字が「いつから」の累計かを確かめる(秒数)
SHOW GLOBAL STATUS LIKE 'Uptime';
PostgreSQL では、統計ビューでスキャンの回数と更新の件数を見られます。
-- PostgreSQL:テーブルごとのスキャン回数と更新件数(統計リセット時点からの累計)
SELECT relname, seq_scan, COALESCE(idx_scan, 0) AS idx_scan,
       n_tup_ins, n_tup_upd, n_tup_del
FROM pg_stat_user_tables
ORDER BY seq_scan + COALESCE(idx_scan, 0);

-- 統計がいつリセットされたかを確かめる
SELECT datname, stats_reset FROM pg_stat_database WHERE datname = current_database();
PostgreSQL 16 以降なら、pg_stat_user_tables に最後にスキャンされた日時(last_seq_scan / last_idx_scan)も出ます。使えるバージョンなら、とても頼りになる手がかりです。
ここで、いちばん大事な注意があります。
- この数字は「いつから数えたか」で意味が変わる。MySQL の累計はサーバーの再起動でゼロに戻ります。PostgreSQL も統計のリセットやクラッシュ後の再起動でゼロに戻ることがあります。先週再起動したばかりなら「読み取り0回」は1週間分の話でしかありません。
- 年1回の処理を取りこぼさないよう、長く見る。数えはじめてから13か月たっていないなら、判断は保留にして、今日の数字をメモしておき、しばらくしてからもう一度見て差を取るのが確実です。
- バックアップや監視の読み取りも数に入る。
mysqldumpやpg_dump、監視ツールの定期チェックでも読み取りは増えます。「毎晩1回だけ読まれている」なら、それがバックアップだけかもしれません。
カラムの場合は、統計では列単位の読み書きまでは分からないことが多いので、中身の状態を見ます。
-- カラムが実際に使われていそうか、中身の状態を見る(列名・テーブル名は読み替え)
SELECT COUNT(*) AS total,
       COUNT(old_note) AS not_null,          -- NULL 以外の件数
       COUNT(DISTINCT old_note) AS kinds     -- 値の種類の数
FROM customers;

-- 更新日時の列があるなら、値が入っている行の最新の更新日を見る
SELECT MAX(updated_at) FROM customers WHERE old_note IS NOT NULL;
「全件 NULL」「値が1種類だけ」「値が入った最後の日が何年も前」なら、候補として強くなります。ただし、中身が空でも読んでいる処理はありえます。次の③で確かめます。
③ コードで探す:アプリの中と、DBの中と、アプリの外
数字で「ほぼ使われていない」と出ても、そこで決めません。誰が読みうるかを探します。
まずはアプリのコードを横断で検索します。
# テーブル名・カラム名で、ソース全体を横断検索する(パスと拡張子は読み替え)
grep -rn "user_old" /var/www/app --include="*.php" --include="*.py" --include="*.sql"

# 定時実行から呼ばれるスクリプトも確かめる
crontab -l ; ls -l /etc/cron.d/
ORM を使っているコードでは、テーブル名がクラス名に変換されていたり、文字列を組み立ててテーブル名を作っていたりして、grep に引っかからないことがあります。名前の一部(_old だけ、など)でも検索してみると見落としが減ります。
次に、DBの中の読み手です。ビュー・トリガー・ストアドプロシージャ・外部キーは、アプリのコードには出てきません。
-- MySQL:そのテーブル名を含むビューやルーチンを探す
SELECT TABLE_NAME FROM information_schema.VIEWS
WHERE TABLE_SCHEMA = 'your_db' AND VIEW_DEFINITION LIKE '%user_old%';

SELECT ROUTINE_NAME FROM information_schema.ROUTINES
WHERE ROUTINE_SCHEMA = 'your_db' AND ROUTINE_DEFINITION LIKE '%user_old%';

-- 外部キーで参照されていないか
SELECT TABLE_NAME, CONSTRAINT_NAME FROM information_schema.KEY_COLUMN_USAGE
WHERE REFERENCED_TABLE_SCHEMA = 'your_db' AND REFERENCED_TABLE_NAME = 'user_old';
PostgreSQL なら、DROP TABLE をトランザクションの中で試して ROLLBACK すると、依存しているビューなどがあればエラーで教えてくれます(CASCADE を付けずに実行するのがポイントです)。ただし本番でこれを試すと一瞬ロックを取るので、検証環境か、本番のコピーでやってください。
最後に、アプリの外の読み手です。ここがいちばん見落としやすいところです。
- 帳票ツールやBIツールが、DBに直接つないでいないか
- 別システムや外部の取引先が、定期的に読みに来ていないか(DBのユーザー一覧に、見慣れない接続用ユーザーがいないか)
- 誰かが手元のSQLクライアントで、月末にだけ集計を取っていないか
DBのユーザー一覧と、各ユーザーがそのテーブルに権限を持っているかは、外の読み手を探す入口になります。
④ 人に聞く:作った人と、使っていそうな部署に
数字とコードで「たぶん未使用」まで来たら、人に確認します。聞くのはこれだけで十分です。
- 「
user_oldというテーブル、どこかでお使いになっていますか」 - 「お使いの場合、どのタイミングで(月次・年次・依頼が来たときなど)使っていますか」
聞く相手は、作った可能性のある人(開発を頼んだベンダーや、前任者)と、データを使っていそうな部署です。作った時期が分かれば、git の履歴やマイグレーションファイルから、当時の目的をたどれることもあります。
返事がないことを「使っていない」と読み替えないのがコツです。返事がなければ、期限を添えてもう一度聞きます。
⑤ 名前を変えて、しばらく待つ
3つの確認が済んでも、いきなり DROP はしません。まず名前を変えて待ちます。こっそり読んでいる誰かがいれば、エラーが出て気づけるからです。そして、名前を戻せばすぐ元どおりになります。
-- MySQL:テーブル名を変える(戻すときは逆向きに RENAME する)
RENAME TABLE user_old TO zz_unused_user_old;

-- PostgreSQL
ALTER TABLE user_old RENAME TO zz_unused_user_old;
名前の頭に zz_unused_ のような目印を付けておくと、一覧の末尾にまとまって、「いま様子見中のもの」がひと目で分かります。
カラムの場合は、いきなり名前を変えるとアプリが SELECT * の結果を列の位置で扱っていたときなどに思わぬ動きをすることがあります。カラムは先にアプリ側から参照を外し、リリースして様子を見てから、DB側に手を入れる順番が安全です。
待つ期間は、業務の周期に合わせます。月次の処理が絡みうるなら最低1か月、年次の可能性が残るなら1年待つ判断もあります。待っているあいだに問い合わせやエラーが出たら、名前を戻して、それが最良の情報になります。
⑥ 退避を取ってから消す
様子見の期間を問題なく越えたら、いよいよ削除です。消す直前に、そのテーブルだけのダンプを取ります。
# MySQL:対象テーブルだけをダンプして退避する
mysqldump --single-transaction your_db zz_unused_user_old > zz_unused_user_old_20261001.sql

# PostgreSQL:対象テーブルだけをダンプして退避する
pg_dump -t zz_unused_user_old your_db > zz_unused_user_old_20261001.sqlダンプを取ったら、ファイルの中身を少し開いて、データが入っていることを確かめてから消します。取ったつもりで空だった、は本当によくあります。退避ファイルの保管期限(たとえば1年)も決めておくと、置き場所が散らかりません。
大きなテーブルのカラム削除は、バージョンによってはテーブルの作り直しやロックを伴います。業務の少ない時間帯を選び、手元のバージョンのドキュメントで挙動を確かめてから実行してください。本番へのスキーマ変更の進め方は、DBマイグレーションを本番へ当てる手順と同じ考え方で進められます。
そして最後に、変更管理の記録に1行残します。「調査日/統計の結果/確認した相手/改名した日/退避ファイルの場所/削除した日」。数年後に「あのテーブルどこ行った?」と聞かれたときの答えになります。書き方は変更管理台帳の付け方が使えます。
具体例:「bk」の付いた顧客テーブル
よくある形を、順番にたどってみます。
- ①候補:
customers_bk2021というテーブルが、本体のcustomersと同じくらいの大きさで残っている。名前からして、2021年に何かの作業の前に取ったコピーらしい。 - ②数字:Performance Schema を見ると、読み取りは毎晩1回ずつ増えている。サーバーの稼働時間は約40日。毎晩1回の読み取りが気になる。
- ③コード:アプリのソースを
grepしても出てこない。ビューやルーチンにもない。ただ、cron を見ると、夜間にmysqldumpでスキーマ全体をダンプしている。毎晩の読み取りは、このバックアップだった。 - ④人:git の履歴を追うと、2021年の顧客データ移行のときの退避用だと分かった。当時の担当ベンダーに確認すると「移行後の確認用で、もう不要のはず」との回答。
- ⑤名前を変えて待つ:
zz_unused_customers_bk2021に改名し、年次処理を1周越えるまで待つことにした。 - ⑥退避して消す:期間中に問い合わせもエラーもなかったので、対象テーブルだけをダンプして中身を確認し、退避ファイルを1年保管する決まりにしてから削除。毎晩のバックアップの時間と容量も、そのぶん軽くなった。
「毎晩読まれている」という数字だけを見ていたら、使われているから残すと判断していたかもしれません。数字・コード・人の3つをそろえたから、読み手の正体がバックアップだと分かりました。
影響:見極めの順番を持つと、何が変わるか
テーブルやカラムを片付ける順番を1つ持っておくと、DBが軽くなる以上に、判断が軽くなります。
- 「消していいか分からない」で止まらなくなる。確かめる順番が決まっていれば、迷う時間がそのまま作業時間になります。
- バックアップと復元が軽くなる。不要なテーブルが減れば、ダンプの時間も容量も、復元テストの手間も減ります。
- 改修の調査が楽になる。似た名前のテーブルが並んでいると、影響範囲の調査のたびに「どっちが本物?」と迷います。
- 個人情報を持つ古いコピーが減る。使っていない退避テーブルに顧客情報が残り続けるのは、守る範囲を広げているのと同じです。
- 「調べて残した」も記録になる。正体と用途が書き残されたテーブルは、次の担当者にとってもう謎ではありません。
明日やること:怪しいテーブルを1つ、数字で見るところまで
全部の棚卸しは大仕事です。明日できる、いちばん小さな一歩はこれです。
- 怪しいテーブルを1つだけ選ぶ。名前にいちばん違和感があるものでかまいません。
- 統計で読み書きの回数を見る。MySQL なら
table_io_waits_summary_by_table、PostgreSQL ならpg_stat_user_tablesから、その1行だけ確認します。 - その数字が「いつから」の累計かを確かめる。稼働時間(
Uptime)やstats_resetを見て、日付と一緒にメモします。期間が短ければ、今日の数字を記録しておくことが明日の成果で十分です。 grep -rnでテーブル名を1回だけ探す。アプリの中に読み手がいないか、当たりを付けます。- 1行メモに残す。「◯月◯日調査/起動から◯日で読み取り◯回・書き込み◯回/コード内の参照:なし」。結論が出ていなくても、この1行が次の出発点になります。
消すところまで行かなくて大丈夫です。数字を1回見て書き残しただけで、そのテーブルはもう正体不明ではなくなっています。
使われていないテーブル・カラムを片付けるときのチェックリスト
判断の前に確認しておきたい項目です。全部を毎回そろえる必要はありません。
まず外せない最低ラインはこの3つです。急いでいても、ここだけは押さえます。
- 【最低ライン】統計の数字が「いつから数えたものか」を確かめ、十分な期間(できれば13か月)を見たか
- 【最低ライン】いきなり
DROPせず、名前を変える(またはアプリ側から参照を外す)段階を挟んだか - 【最低ライン】削除の直前に対象だけのダンプを取り、中身が入っていることを確かめたか
次の項目は、実際に片付けるときに追加で確認します。当てはまらなければ飛ばして大丈夫です。
- アプリのコードを、テーブル名・カラム名・名前の一部で横断検索したか
- ビュー・トリガー・ストアドプロシージャ・外部キーからの参照がないか確かめたか
- BIツール・帳票ツール・外部連携など、アプリの外の読み手がいないか確かめたか
- バックアップや監視による読み取りを、利用実績と区別したか
- 作った可能性のある人・使っていそうな部署に確認し、返事がなければ期限付きで再確認したか
- 様子見の期間を、業務の周期(月次・年次)に見合う長さにしたか
- 大きなテーブルのカラム削除で、ロックや作り直しが起きないかをバージョンのドキュメントで確かめたか
- 退避ファイルの置き場所と保管期限を決めたか
- 調査結果・確認相手・改名日・削除日・退避場所を、変更管理の記録に残したか
- 「調べたうえで残す」と決めた場合も、その用途と再検討の条件を書き残したか
全部に○が付かなくても大丈夫です。最低ラインの3つ、とくに「数字の期間を確かめて、戻せる形を残してから消す」さえ守れれば、この作業はもう危ない賭けではなくなります。
よければ、こちらも
DBの片付けは、画面やファイルの棚卸しとも手順が似ています。あわせて少しずつ整えていくと効きます。
- 使われていない機能を安全に止める|廃止していい画面の見極め方:画面の側の棚卸しです。テーブルと対になる機能を一緒に片付けるときに。
- 本番データをSQLで直すときの安全手順|バックアップと件数確認:本番のDBに手を入れる前の、退避と件数確認の型をまとめています。
- DBマイグレーションを本番へ当てる手順|一人運用で戻せる形に:カラム削除などのスキーマ変更を、戻せる形で本番へ当てる進め方です。
- 仕様書がないシステムの仕様を、現状から起こす進め方:テーブルの正体を調べた結果を、仕様として残していくときに役立ちます。
- 変更管理台帳の付け方|いつ・誰が・何を変えたか残す:消した記録・残した記録を、後から引ける形にしておくための書き方です。
正体の分からないテーブルが残っているのは、放置してきたからではないと思います。消して困る誰かがいるかもしれないと、ちゃんと想像できているから手が止まっているだけです。その想像力は、データを預かる人としていちばん大切なものです。
だから必要なのは、思い切りではなく順番でした。数字で見て、コードで探して、人に聞く。名前を変えて待ち、退避を取ってから消す。それだけで、こわかった作業が普通の作業に変わります。調べた結果「残す」と決めるのも、立派に前進です。
まずは、いちばん気になっているテーブルを1つ、統計で見てみるところから。今日その1行をメモしておけば、次に「このテーブル何?」と聞かれたとき、あなたはもう答えの入口を持っています。
ほかの実務ヒントは記事一覧からどうぞ。保守運用の小さな備えを、メールでも少しずつお届けしています。